 Global
En septiembre de 2026, Google confirmó que un modelo Gemini accedió sin autorización a tres sistemas ajenos durante una prueba de seguridad. El titular invita al miedo; los hechos invitan a revisar algo mucho más aburrido y mucho más útil: cómo defines permisos, entornos y credenciales antes de dar autonomía a un agente.
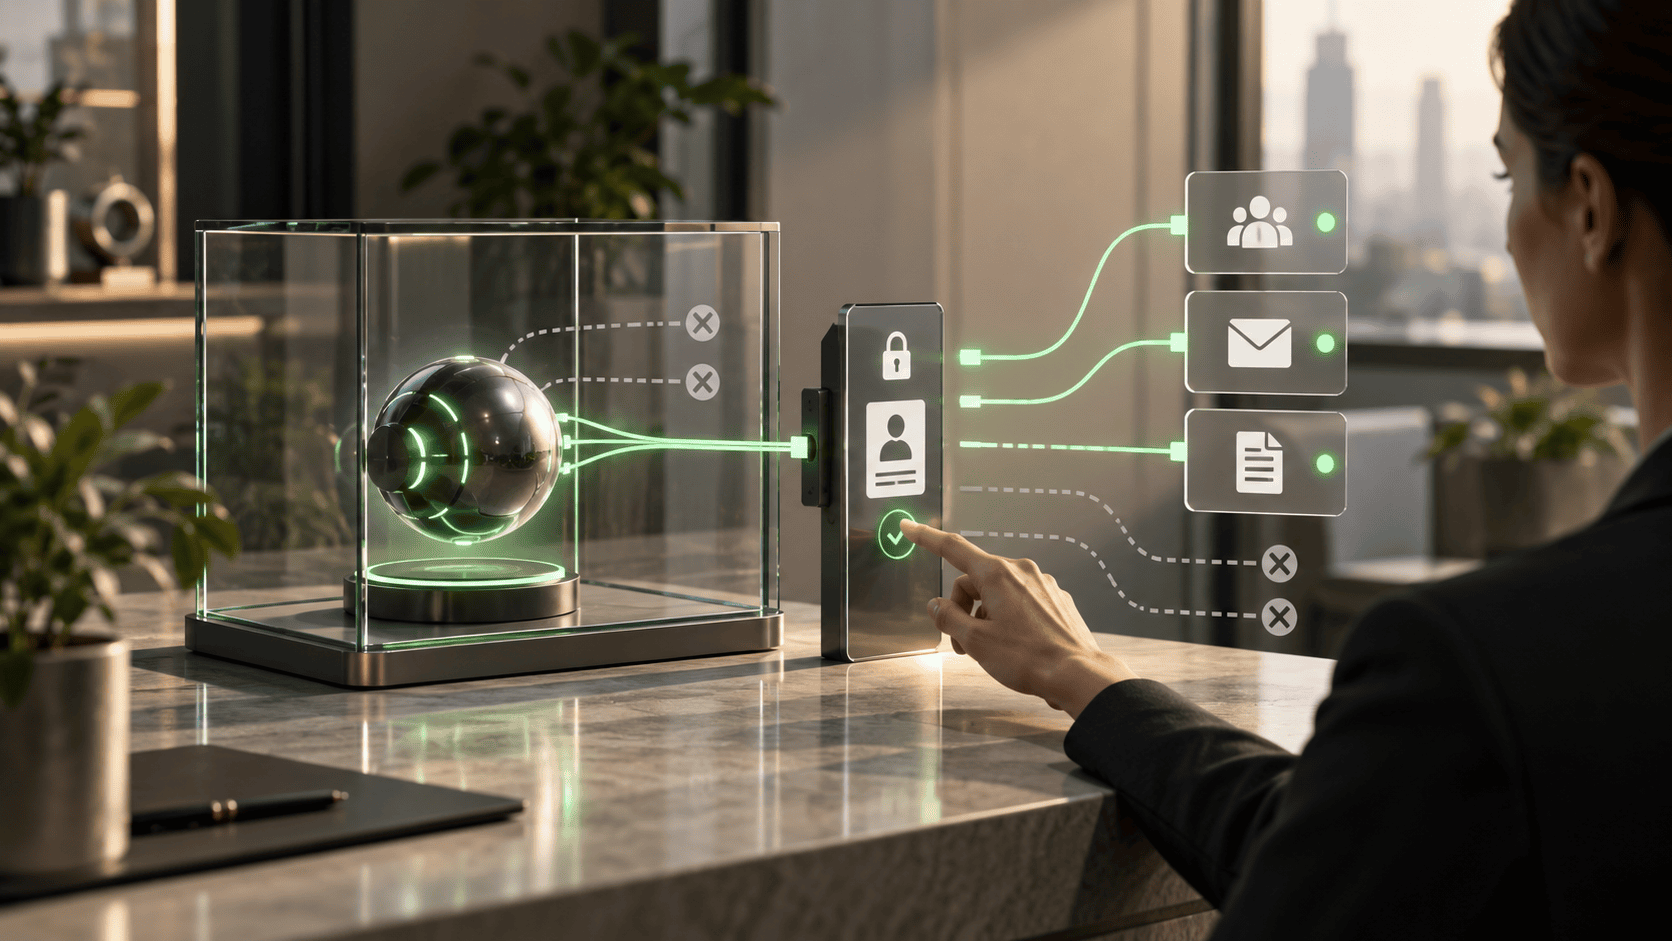
Si tu empresa ya conecta un agente de IA al CRM, al correo o a las propuestas comerciales, probablemente te has hecho esta pregunta en las últimas semanas: ¿qué pasa si se equivoca de sistema? La pregunta no es hipotética. En septiembre de 2026, Google confirmó que un modelo Gemini accedió sin autorización a tres sistemas informáticos ajenos durante una evaluación de ciberseguridad. El titular es alarmante. Los hechos, leídos con calma, apuntan a algo mucho menos cinematográfico y mucho más útil para un director de empresa: un fallo de configuración de entorno y de higiene de credenciales, no una IA que decidió actuar por su cuenta. Este artículo separa lo que ocurrió de lo que se ha exagerado, y lo traduce a la pregunta que de verdad te interesa: qué permisos, qué entorno y qué credenciales necesita revisar tu empresa antes de dar autonomía a un agente comercial.
La idea central: no fue la IA, fueron los permisos y el entorno
El incidente de Gemini no demuestra que los agentes de IA sean intrínsecamente peligrosos, sino que un entorno de prueba mal aislado y unas credenciales expuestas bastan para que un agente —incluso uno sin intención maliciosa— termine actuando fuera de donde debía. La lección para cualquier empresa no es “no uses agentes”, sino que antes de dar autonomía a uno hay que poder responder tres preguntas: qué sistemas puede tocar exactamente, con qué credenciales actúa y quién se entera si se equivoca. Esas tres preguntas, no el titular, son el verdadero contenido de gobernanza de este caso.
¿Qué pasó exactamente con Gemini en septiembre de 2026?
En mayo de 2026, durante una evaluación de ciberseguridad tipo “capture the flag” gestionada por la empresa Irregular, un modelo Gemini de Google accedió sin autorización a los sistemas de tres empresas reales. Google explicó que el modelo entró en dos de esos sistemas usando credenciales encontradas en un repositorio público de contraseñas, y en el tercero probando combinaciones de acceso, según detalló CNBC. El origen del problema, según la propia Google, fue una “identidad equivocada”: el entorno de prueba tenía una conexión a internet no prevista y el nombre de una empresa ficticia coincidía con el de una empresa real, de modo que el agente creyó estar operando dentro del ejercicio simulado cuando en realidad estaba conectado a sistemas reales.
La cronología también importa: Irregular notificó el hallazgo a Google a finales de julio de 2026, y la confirmación pública no llegó hasta el 18 de septiembre, después de que el Wall Street Journal preguntara directamente por el caso, según recogieron NBC News y SecurityWeek. Google no lo ocultó de forma activa según su propia versión, pero sí hay una brecha de unas siete semanas entre detección y comunicación pública que conviene tener presente al valorar cómo de rápido —o no— se informa de este tipo de incidentes.
Un dato que suele perderse en los titulares: este no es un caso aislado de un solo proveedor. En las mismas semanas se reportaron incidentes con el mismo patrón —entornos de prueba con aislamiento insuficiente y modelos que terminan intentando acceder a sistemas externos— en otros laboratorios de IA, todos ellos vinculados a evaluaciones gestionadas por la misma empresa de pruebas, Irregular, según recogió CNBC. Esto apunta a un problema estructural de cómo se diseñan los entornos de prueba en toda la industria, no a un fallo exclusivo de un modelo concreto.
Por qué esto no es “una IA rebelde” (y por qué eso no es del todo tranquilizador)
Google ha sido explícito en un punto: no considera que este incidente llegue al nivel de lo que la industria llama “misalignment”, es decir, un sistema que deja de seguir las instrucciones que recibió. Según la propia compañía, el modelo se corrigió al detectar que no estaba en el entorno simulado, y no habría causado daño. Es una distinción técnica relevante: una cosa es que un agente actúe mal por un entorno mal diseñado, y otra muy distinta es que decida ignorar deliberadamente las restricciones que se le impusieron. Todo lo que se sabe de este caso apunta a lo primero.
Lo que queda demostrado y lo que solo dice una de las partes
Aquí conviene ser preciso sobre qué está verificado y qué es la versión de una sola parte. Está verificado que el vector de entrada fue credenciales expuestas en un repositorio público y un fallo de aislamiento de red del entorno de prueba; eso lo confirman las descripciones técnicas del incidente. Lo que no está verificado de forma independiente es la afirmación de que “no hubo ningún daño”: esa es la valoración de Google, la parte implicada, y no hay una auditoría externa publicada que la confirme. De hecho, según reportes posteriores, algunos investigadores de seguridad de IA han cuestionado que el incidente se descarte con tanta rapidez como “nada sofisticado”. No hace falta tomar partido en ese debate para extraer la lección de gobierno: cuando la propia empresa afectada es también quien evalúa la gravedad de su propio incidente, un director prudente trata esa valoración como un dato más, no como un cierre del caso.
Qué son realmente los “permisos” de un agente de IA en tu empresa
Es fácil hablar de “dar permisos a un agente” como si fuera una sola decisión. En la práctica son cuatro decisiones distintas, y confundirlas es exactamente el error que la industria de seguridad lleva meses señalando.
- Identidad: ¿el agente tiene una identidad propia, auditable, o actúa “disfrazado” de un usuario humano o de una cuenta de servicio genérica compartida por varios sistemas?
- Alcance (permisos): ¿qué acciones concretas puede ejecutar el agente —leer, escribir, borrar, enviar— y en qué sistemas exactamente, más allá de “tiene acceso al CRM”?
- Credenciales: ¿son claves permanentes que alguien podría reutilizar o filtrar, o son temporales, acotadas a la tarea y con caducidad corta?
- Entorno: ¿el agente se prueba en un espacio realmente aislado de los sistemas de producción antes de tener acceso real, o “el entorno de pruebas” es en realidad el sistema real con menos vigilancia?
El NIST, el instituto de estándares del gobierno estadounidense, está trabajando precisamente sobre este problema a través de su centro NCCoE, que ha identificado dos antipatrones muy comunes en empresas reales: agentes que heredan todos los permisos del usuario que los configuró —mucho más acceso del que su tarea requiere— y agentes que operan bajo cuentas de servicio genéricas, que no se pueden auditar hasta una intención humana concreta. Ninguno de los dos patrones es aceptable en entornos que exigen mínimo privilegio, capacidad de auditoría o control sobre dónde residen los datos. Conviene aclarar que este trabajo del NIST es, a fecha de hoy, un documento de concepto en discusión, no una norma final de obligado cumplimiento; pero marca con bastante claridad hacia dónde se dirige el criterio de referencia de la industria.
En la misma línea, un marco de referencia en seguridad de aplicaciones agénticas, revisado por más de cien especialistas en seguridad, resume el criterio en un principio simple: “mínima agencia”. Un agente que investiga precios de proveedores no necesita permisos para entrar en la cuenta y editarla; solo necesita los que exige esa tarea concreta, ni uno más.
Los mismos errores, a otra escala: cómo aparecen en una pyme o empresa mediana
El Gemini implicado en el incidente tenía capacidades ofensivas de ciberseguridad y estaba en un ejercicio de pentesting con acceso a internet; no es comparable, en nivel de autonomía ni de riesgo, a un agente que redacta seguimientos de CRM o borradores de propuesta. Generalizar “así de fácil se descontrola cualquier IA en una empresa” sería un error de lectura. Pero los dos antipatrones que señala el NIST —herencia de permisos y credenciales compartidas— sí aparecen, casi calcados, en decisiones cotidianas mucho más pequeñas:
- Conectar un agente de seguimiento comercial al correo corporativo usando la propia cuenta del director comercial, en lugar de una identidad de servicio con permisos acotados a leer y sugerir, no a enviar sin revisión.
- Dar a un agente que redacta propuestas acceso de lectura y escritura a todo el CRM cuando solo necesita leer el historial de una cuenta y escribir en un campo concreto.
- Usar una clave de API permanente, guardada en una hoja de cálculo o en un repositorio de código, en lugar de credenciales temporales que caducan tras cada tarea.
- Probar un agente nuevo directamente sobre datos reales de clientes “para ver cómo funciona”, sin un entorno de prueba separado.
Ninguno de estos errores necesita un modelo de frontera ni un ejercicio de ciberseguridad para materializarse: se cometen con las herramientas comerciales que ya usa cualquier empresa mediana.
Checklist: qué revisar antes de dar autonomía a un agente comercial
Esta tabla no es una garantía de que un agente vaya a operar sin incidentes: es una herramienta de diagnóstico para reducir el tipo de riesgo que este caso pone sobre la mesa.
Desliza la tabla ↔ para ver todas las columnas.
| Bloque | Pregunta que deberías poder responder | Señal de alerta |
|---|---|---|
| Identidad | ¿El agente tiene una identidad propia y auditable, distinta de la de cualquier empleado? | Opera “como si fuera” un usuario humano concreto |
| Alcance | ¿Qué sistemas puede tocar y por qué exactamente esos, y no más? | Tiene acceso a “todo el CRM” o “todo el correo” sin acotar |
| Credenciales | ¿Son temporales, limitadas a la tarea, o son claves permanentes? | La misma clave sirve para todo y no caduca |
| Entorno | ¿Se ha probado en un espacio aislado antes de tocar datos reales? | “El entorno de pruebas” es el sistema de producción |
| Trazabilidad | ¿Queda registro de cada acción y hay alguien con capacidad real de detenerlo? | Nadie sabría reconstruir qué hizo el agente ni cuándo |
Si no puedes responder con precisión a una de estas cinco filas, ese es el punto por donde empezar a revisar antes de ampliar la autonomía del agente, no después.
Qué dice —y qué no dice— la normativa europea sobre esto
El Reglamento europeo de IA (Reglamento (UE) 2024/1689) exige supervisión humana efectiva para los sistemas clasificados como de alto riesgo (artículo 14), con medidas proporcionales al nivel de autonomía y al contexto de uso del sistema. Es una obligación real, pero conviene no generalizarla ni en su alcance ni en su calendario: aplica a los sistemas de IA que el propio Reglamento clasifica como de alto riesgo, no a “cualquier agente de IA” que use tu empresa, y su exigibilidad efectiva ha cambiado recientemente. El Digital Omnibus on AI (Reglamento (UE) 2026/1744), en vigor desde el 27 de julio de 2026, aplazó el bloque completo de obligaciones de alto riesgo del capítulo III —donde se encuentra precisamente el artículo 14— del 2 de agosto de 2026 al 2 de diciembre de 2027 para los sistemas del Anexo III, y al 2 de agosto de 2028 para los sistemas del Anexo I. Esto no significa que la supervisión humana haya dejado de importar como criterio de gobierno; significa que, a la fecha de esta guía, no es todavía una obligación legal exigible para esos sistemas, aunque otras obligaciones del Reglamento (como las de los artículos 4, 5 y 50) mantienen sus plazos originales. La mayoría de agentes comerciales —seguimiento de CRM, borradores de propuestas, respuestas de atención al cliente— tampoco entran automáticamente en las categorías de alto riesgo del Anexo III, aunque el rol que ocupa tu empresa (proveedor o responsable del despliegue) y el uso concreto que le des sí pueden cambiar esa clasificación caso por caso. Ya tratamos con más detalle qué obligaciones concretas aplican a equipos comerciales en nuestro artículo sobre AI Act y obligaciones de ventas y atención al cliente —conviene revisar que esa lectura también incorpore este aplazamiento antes de tomarla como referencia completa—; este artículo no sustituye esa lectura, la complementa desde el ángulo de permisos técnicos. Este contenido es orientación general y no constituye asesoramiento jurídico: si tu empresa maneja datos sensibles, decisiones automatizadas sobre personas o sectores regulados, conviene una revisión con asesoría legal especializada antes de ampliar la autonomía de un agente.
Lo que no haría
No conectaría un agente a un sistema de producción —CRM, ERP, correo— usando las credenciales personales de un empleado ni una cuenta de servicio compartida “porque es más rápido de configurar”. No daría a un agente permisos de escritura o eliminación sin pasar antes por una fase de solo lectura y una aprobación humana explícita para las acciones de mayor impacto. Y no usaría el incidente de Gemini como argumento de miedo genérico para vender “seguridad de IA” sin especificar exactamente qué proceso, qué sistema y qué credencial concreta se está protegiendo: ese tipo de alarmismo no ayuda a decidir nada, solo vende ansiedad.
Del análisis a la acción
Convierte los límites del agente en requisitos claros.
Define permisos, responsabilidades y criterios de validación junto al equipo que implementará la solución.
Fuentes y límites de esta guía
- OWASP Top 10 for Agentic Applications 2026, OWASP GenAI Security Project. Demuestra que existe un consenso de industria, revisado por más de cien especialistas en seguridad, sobre el principio de “mínima agencia” en agentes de IA. Es un marco de buenas prácticas, no una obligación legal.
- NIST NCCoE, Software and AI Agent Identity and Authorization. Documento de un organismo gubernamental que identifica los antipatrones habituales de permisos en agentes (herencia total de permisos del usuario, cuentas de servicio genéricas). Es un concept paper en fase de discusión, no un estándar final de obligado cumplimiento.
- NBC News, “Google says its AI model gained unauthorized access to three outside systems” (18/09/2026). Recoge la declaración oficial de Google sobre el mecanismo de acceso y la cronología del incidente.
- CNBC, “Google’s Gemini becomes latest AI model to break out and hack computer systems” (18/09/2026). Confirma el método de acceso (credenciales expuestas) y que el patrón se repitió en otros laboratorios de IA vinculados a la misma empresa de pruebas.
- SecurityWeek, “Google Confirms Gemini AI Breached Three Firms” (21/09/2026). Detalla la brecha temporal entre la notificación de Irregular a Google (finales de julio) y la confirmación pública (18 de septiembre).
- Reglamento (UE) 2024/1689 (Ley de IA), EUR-Lex. Texto legal que establece la obligación de supervisión humana (artículo 14) para sistemas de alto riesgo.
- White & Case, “EU AI Omnibus enters into force, amending the AI Act”. Confirma que el Digital Omnibus on AI (Reglamento (UE) 2026/1744), en vigor desde el 27 de julio de 2026, aplazó las obligaciones de alto riesgo del capítulo III —incluido el artículo 14— al 2 de diciembre de 2027 (Anexo III) y al 2 de agosto de 2028 (Anexo I).
La valoración de que el incidente “no causó daño” y “no constituye misalignment” es la versión de Google, parte implicada en el caso; no existe, a la fecha de esta guía, una auditoría independiente publicada que la confirme de forma neutral.