 Global
El precio del token cae mes a mes, pero la factura de IA de muchas empresas no baja al mismo ritmo: la causa casi siempre es que se presupuesta por licencia en lugar de por proceso.
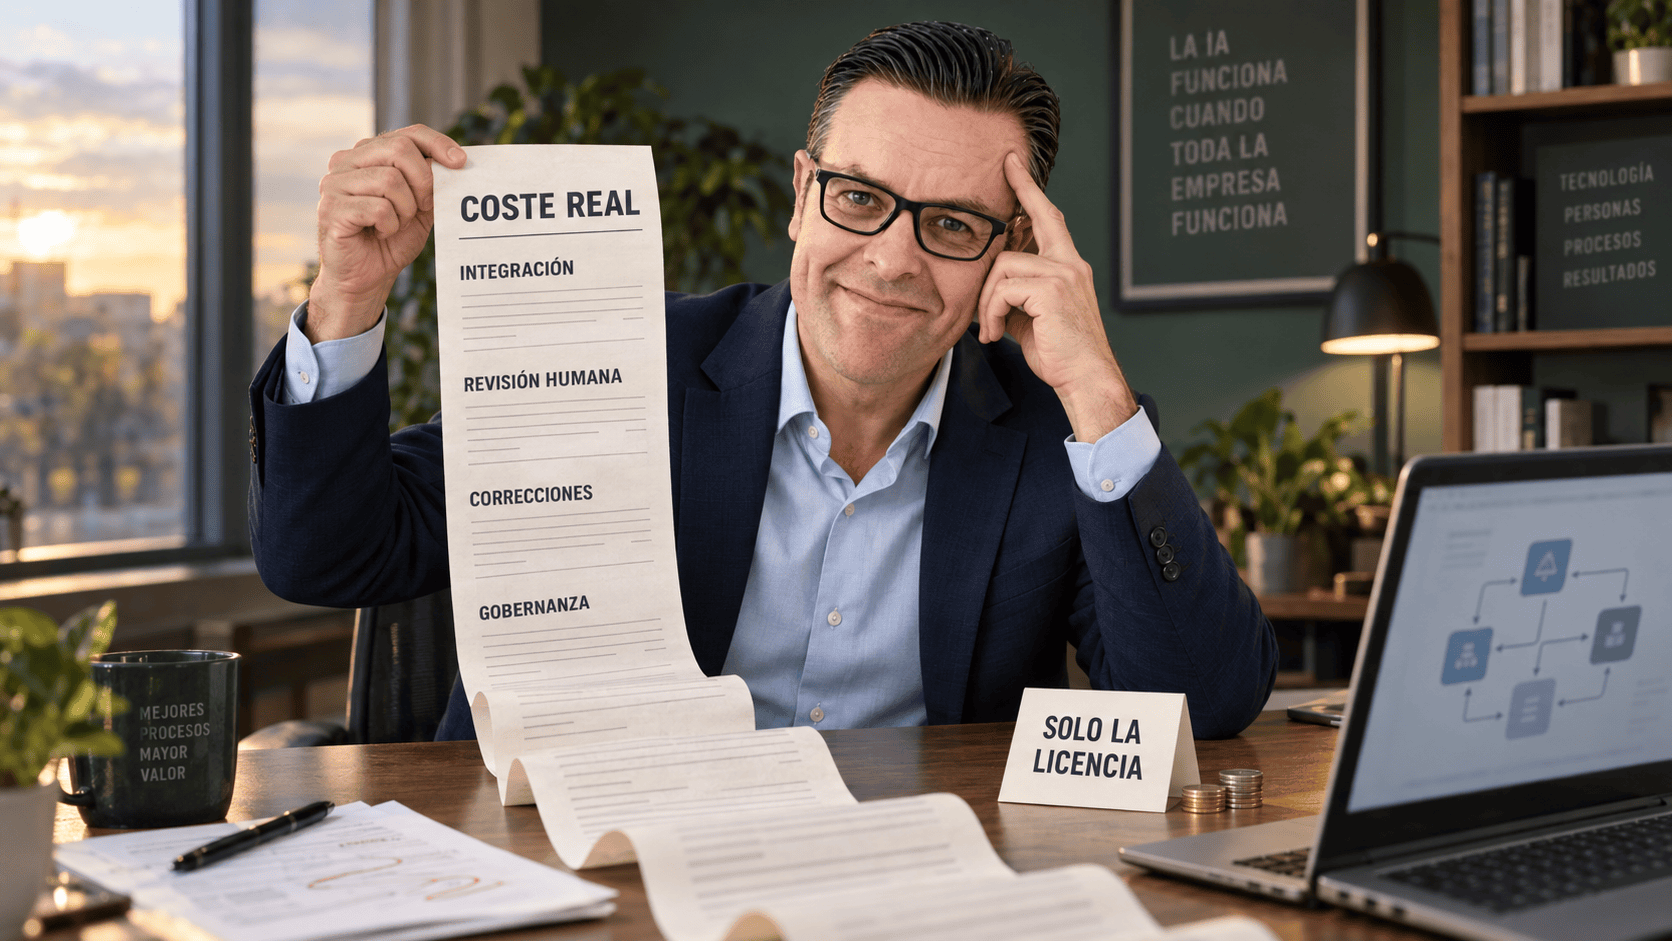
Apruebas una herramienta de IA para el equipo comercial con una cotización clara: tantos euros por asiento al mes. Seis meses después, la factura ha subido, aunque el proveedor del modelo acaba de anunciar una bajada de precios. Nadie ha mentido: simplemente, la licencia nunca fue el coste real. El coste real incluye la integración con el CRM, el tiempo que alguien dedica a revisar lo que genera el modelo, las correcciones cuando se equivoca, y el uso que han empezado a hacer otros departamentos sin que TI o finanzas lo supieran. Eso es lo que no aparece en la cotización inicial.
Este artículo no trata de si la IA es cara o barata en abstracto. Trata de una confusión concreta y medible: presupuestar por la unidad equivocada. Mientras el precio del token sigue una trayectoria, el coste de los procesos que construyes sobre ese token puede seguir otra completamente distinta, y en sentido contrario.
La respuesta corta: por qué el precio del token no es el coste de la IA
El coste de la IA en una empresa no es el precio del token ni el de la licencia mensual: es lo que cuesta completar un proceso de negocio de principio a fin, incluida la supervisión humana, las correcciones y la integración con el resto del sistema comercial. Dos empresas pueden pagar el mismo precio por el mismo modelo y tener un coste real completamente distinto, porque ese coste depende del proceso que rodea al modelo, no del modelo en sí. Presupuestar por licencia es mirar la etiqueta; presupuestar por proceso es mirar la factura completa.
El precio del token baja. ¿Por qué tu factura no baja igual?
Hay un dato que circula con frecuencia como prueba de que “la IA cada vez cuesta menos”. Según el Ramp AI Index de septiembre de 2026, entre los clientes corporativos de Ramp el precio efectivo pagado por millón de tokens cayó un 41%, hasta 0,68 dólares, frente al pico de 1,15 dólares alcanzado en marzo de 2026. Es un dato real, pero con un alcance muy concreto: mide el gasto en tokens y API de una base de clientes de una plataforma de gestión de gasto estadounidense, con sesgo hacia startups y empresas tecnológicas más pequeñas. No es un dato del mercado español ni europeo, y no incluye contratos, asientos ni licencias.
El problema aparece cuando se asume que ese abaratamiento del precio unitario se traduce automáticamente en menor gasto total. Gartner prevé justo lo contrario para un tipo concreto de uso de IA: el coste de inferencia por flujo de trabajo agéntico se multiplicará por más de cinco de aquí a 2028, un fenómeno que la consultora denomina “la paradoja de la inferencia”. La explicación de Gartner es directa: cada generación sucesiva de capacidad de IA necesita más tokens, y a menudo más caros, por lo que los responsables de producto no pueden confiar en que una economía de tokens más eficiente baste para racionalizar el coste total.
El mecanismo es sencillo de entender si distingues dos tipos de uso. Un chatbot procesa una petición y entrega una respuesta: una llamada, un coste. Un agente, en cambio, puede necesitar varias rondas de razonamiento encadenado —consultar una herramienta, verificar un dato, generar un borrador, revisar su propia respuesta— antes de completar una sola tarea. Según Gartner, usar un modelo de razonamiento agéntico puede multiplicar por al menos cinco el coste de inferencia frente a una interacción básica de chatbot, y el múltiplo crece cuanto más exigente es el flujo. Un asistente que redacta un correo no es comparable, en coste, a un agente que investiga un cliente, cruza datos del CRM, redacta una propuesta y la ajusta tras una primera revisión.
El error de presupuestar por licencia
La mayoría de los presupuestos de IA que llegan a dirección se construyen sobre un único número: el precio del asiento o de la suscripción mensual. Es un error comprensible —es el único dato que el proveedor pone fácil de encontrar— y también es la causa más frecuente de que un proyecto de IA pierda credibilidad ante el CFO cuando el gasto real empieza a aparecer en otras partidas.
Qué esconde la factura de la herramienta
Un marco de coste total de propiedad (TCO) aplicado a cualquier activo de TI incluye, además del precio de adquisición, partidas como la instalación, la formación, el mantenimiento y el tiempo de inactividad asociado a su uso real, tal y como recoge el marco general de coste total de propiedad de Tractian. Es un marco genérico, pensado para activos industriales y de TI en general, no para IA específicamente, pero la estructura es útil para no quedarse en el precio de etiqueta. Trasladado a un proyecto de IA, suele haber al menos cuatro partidas que no aparecen en la cotización inicial:
- Integración: conectar la herramienta con el CRM, el ERP o el sistema de propuestas no es gratis ni instantáneo, y suele requerir horas de un perfil técnico o de un proveedor externo.
- Supervisión humana: alguien tiene que revisar lo que el modelo produce antes de que llegue a un cliente, especialmente en propuestas, comunicaciones comerciales o contenido técnico.
- Corrección: cuando el resultado no es aprovechable, el tiempo de reescribir o rehacer no desaparece, se desplaza a otra persona del equipo.
- Gobernanza: definir quién puede usar qué datos, con qué permisos y bajo qué revisión, tiene un coste de gestión que rara vez se contabiliza en el proyecto inicial.
Por qué el gasto se escapa de TI
Hay un patrón que explica buena parte de los sobrecostes: la decisión de compra ya no pasa por un único departamento. Según el Capgemini Research Institute, el 59% del gasto en IA generativa se origina hoy en las áreas de negocio, sin intervención directa de TI, y el 68% de las organizaciones encuestadas superó su presupuesto de IA generativa. El 98% de los directivos admite haber adquirido tecnología sin pasar por TI al menos en alguna ocasión. Es una encuesta a 1.000 ejecutivos senior en 14 países, mayoritariamente de grandes organizaciones, así que no debe leerse como una estadística de la pyme española; pero el patrón que describe es reconocible en cualquier tamaño de empresa: el equipo comercial contrata un asistente para propuestas, atención al cliente contrata otro para responder consultas, y nadie suma ambas facturas hasta que finanzas pregunta por qué el gasto en software ha crecido sin una decisión formal detrás.
Si tu empresa todavía no tiene ningún proceso con IA en marcha y quieres evitar este patrón desde el principio, conviene empezar por definir el proceso antes que la herramienta: puedes comprobar encaje antes de aprobar cualquier presupuesto. Y si ya tienes herramientas sueltas aprobadas por distintas áreas, el punto de partida es el mismo que describimos en IA para procesos comerciales: por dónde empezar sin comprar otra herramienta sin criterio: mapear el proceso antes de sumar una herramienta más.
Cómo definir el coste real de un proceso con IA (no de una herramienta)
El cambio de criterio que proponemos en E2M es sencillo de enunciar y exigente de aplicar: dejar de preguntar “¿cuánto cuesta la licencia?” y empezar a preguntar “¿cuánto cuesta completar este proceso, de principio a fin, con IA de por medio?”. La unidad de medida deja de ser el asiento o el token, y pasa a ser la transacción de proceso completada: una propuesta enviada, una consulta de cliente resuelta, un lead cualificado y pasado a seguimiento.
Esa unidad obliga a sumar cinco componentes, no uno:
- Coste de inferencia del modelo (el token o la llamada a la API).
- Coste de integración y mantenimiento técnico del flujo.
- Tiempo de supervisión humana por cada resultado generado.
- Tiempo de corrección cuando el resultado no es aprovechable.
- Coste de gobernanza: permisos, revisión de calidad, cumplimiento.
Una empresa de servicios B2B que use IA para generar primeros borradores de propuestas técnicas no debería preguntarse cuánto cuesta la suscripción al asistente, sino cuánto cuesta —en euros y en horas— cada propuesta que sale de ese proceso, comparado con el coste de generarla sin IA. Si el borrador generado necesita media hora de revisión técnica antes de poder enviarse, esa media hora es coste del proceso, no un efecto colateral gratuito.
Desliza la tabla ↔ para ver todas las columnas.
| Unidad de medida | Qué mide | Qué esconde | Pregunta antes de aprobar presupuesto |
|---|---|---|---|
| Precio por millón de tokens | Coste unitario del modelo en un momento dado | No dice nada sobre cuántas llamadas necesita tu proceso para completarse | ¿Cuántas llamadas al modelo requiere completar una sola tarea real, no una prueba? |
| Precio por licencia o asiento al mes | Coste de acceso a la herramienta | Integración, supervisión, corrección y gobernanza quedan fuera | ¿Qué coste adicional genera cada persona que usa esta licencia, más allá de la cuota? |
| Coste por flujo de trabajo agéntico | Coste de una tarea con varios pasos de razonamiento encadenado | Puede multiplicarse por el número de rondas de razonamiento sin que el precio del token lo refleje | ¿Cuántos pasos internos ejecuta el agente para completar una sola tarea? |
| Coste por proceso de negocio completo | Todo lo anterior, más supervisión, corrección y gobernanza | Nada: es la unidad que de verdad determina el retorno | ¿Cuánto cuesta este proceso de principio a fin, incluida la revisión humana? |
Por qué la adopción sube y el retorno no sigue el mismo ritmo
La confusión entre precio unitario y coste de proceso también explica, en parte, una brecha que aparece en los datos de adopción empresarial. Según la encuesta global de McKinsey de agosto de 2026 (1.719 participantes, recogida entre el 4 de mayo y el 8 de junio de 2026), el 37% de los encuestados atribuye a la IA algún impacto en el EBIT de su organización, una cifra prácticamente igual a la del año anterior, mientras que casi nueve de cada diez organizaciones usan IA de forma regular en al menos una función de negocio. La misma encuesta muestra una diferencia de escala relevante: entre las organizaciones con 1.000 millones de dólares o más de ingresos, el 54% declara haber escalado la IA a nivel de toda la empresa, frente a cerca de un tercio en las organizaciones más pequeñas. Es una encuesta de percepción directiva, no una auditoría financiera independiente, pero el patrón es consistente con lo que describe este artículo: casi todo el mundo usa IA, muy pocos han medido con rigor qué les cuesta y qué les devuelve.
Hay un hallazgo que conviene citar con todas sus salvedades, no como titular. Un informe preliminar del MIT NANDA, publicado en julio de 2025 y basado en 52 entrevistas y 153 encuestas recogidas en conferencias del sector —no revisado por pares ni representativo del conjunto de empresas—, encontró que una proporción muy alta de los pilotos de IA generativa analizados no había generado el retorno esperado por quien lo impulsó. No es un dato cerrado ni extrapolable a “la mayoría de las empresas”; es un hallazgo preliminar con una muestra pequeña y un método de recogida sesgado hacia asistentes a eventos del sector. Lo que sí aporta, con esas limitaciones explícitas, es una señal: escalar un piloto sin haber medido antes su coste real por proceso es un riesgo concreto, no una hipótesis teórica.
Medir antes de escalar: los indicadores mínimos antes de ampliar un piloto
El principio que aplicamos en E2M es el mismo en cualquier proyecto de IA comercial: proceso, después fuentes de información, después responsables claros, después revisión, después métricas, y solo entonces la decisión de escalar. Antes de ampliar un piloto de IA a más equipos o más volumen, hay un conjunto mínimo de indicadores que deberían estar sobre la mesa, no en una estimación aproximada:
- Coste medio por transacción de proceso completada (no por licencia ni por usuario).
- Tiempo de supervisión humana por resultado generado, en minutos, no en percepción.
- Porcentaje de resultados que requieren corrección sustancial antes de poder usarse.
- Quién, fuera de TI o finanzas, está pagando ya herramientas similares.
- Qué pasa con el coste si el volumen se multiplica por tres: ¿crece de forma lineal o se dispara por el tipo de flujo (agéntico frente a uso puntual)?
Si tu empresa todavía no ha definido estos indicadores para el piloto que tiene en marcha, el riesgo no es solo financiero: es que la decisión de escalar o no se tome con la unidad de medida equivocada. Profundizamos en los criterios para saber si conviene esperar en Cuándo una pyme no debería automatizar todavía. Y si estás valorando financiación pública para parte de este gasto, conviene tener claro qué cubre y qué no cubre antes de pedirlo: lo tratamos en Bono IA del Plan IA360: qué sabemos (y qué no) antes de pedirlo.
Lo que no haría E2M
No presupuestaríamos un proyecto de IA mirando solo el precio por token o por asiento mensual: es la parte más visible y la menos representativa del coste real. No aprobaríamos escalar un piloto sin haber medido antes el coste y el tiempo de corrección humana por proceso completo, porque es precisamente ahí donde se esconde el sobrecoste que luego llega a dirección como sorpresa. Y no prometeríamos que la bajada de precio de los modelos se vaya a traducir automáticamente en menor gasto total: el propio dato de Gartner sobre flujos agénticos muestra que puede ocurrir justo lo contrario, y cualquier presupuesto que no contemple ese escenario parte de un supuesto que no está respaldado por la evidencia disponible.
Del análisis a la acción
¿Qué coste tendría aplicar IA a tu proceso?
Empieza por identificar el caso de uso, sus dependencias y la evidencia necesaria antes de decidir una inversión.
Fuentes y límites de esta guía
- Ramp, “September 2026 Ramp AI Index”. Demuestra una caída del 41% en el precio efectivo por millón de tokens entre los clientes corporativos de Ramp entre marzo y septiembre de 2026. Límite: es gasto propietario de una población autoseleccionada, mayoritariamente estadounidense y con sesgo hacia startups; no representa el mercado español ni europeo.
- Gartner, “Gartner Predicts AI Inference Costs Per Agentic Workflow Will Increase More Than Fivefold Through 2028”. Demuestra el razonamiento y la previsión de Gartner sobre el aumento del coste de inferencia en flujos agénticos. Límite: es una predicción de la consultora, con metodología no detallada públicamente, no una medición retrospectiva cerrada.
- Stanford HAI, “Artificial Intelligence Index Report 2025”, Capítulo 1. Demuestra la caída del precio de inferencia para un nivel de rendimiento fijo (benchmark MMLU) entre 2022 y 2024. Límite: mide precio de un nivel de capacidad de modelo, no el coste de ejecutar un proceso empresarial completo; no debe usarse como “la IA se ha abaratado para las empresas”.
- McKinsey & Company, “The state of AI in 2026: On the road to ROI”. Demuestra la brecha entre adopción de IA (casi universal) e impacto declarado en EBIT (37%, estable interanual). Límite: encuesta de percepción directiva autodeclarada, no auditoría financiera independiente.
- Capgemini Research Institute, comunicado sobre “On-Demand tech”. Demuestra que el gasto en IA generativa se decide mayoritariamente fuera de TI y que una mayoría de organizaciones supera su presupuesto de IA. Límite: encuesta a 1.000 ejecutivos senior de grandes organizaciones en 14 países; no representa a la pyme española.
- Tractian, “Total Cost of Ownership”. Aporta el marco conceptual genérico de coste total de propiedad (más allá del precio de adquisición). Límite: es un glosario de proveedor sobre activos de TI/industriales en general, no específico de IA; no se usan sus cifras numéricas en este artículo.
- MIT NANDA, informe preliminar sobre pilotos de IA generativa (julio de 2025). Aporta una señal de que una proporción alta de pilotos no cumple el retorno esperado por quien lo impulsa. Límite explícito: informe preliminar, no revisado por pares, basado en 52 entrevistas y 153 encuestas recogidas en conferencias sectoriales; no representativo del conjunto de empresas.